AWS ALB Tidak Selalu Diperlukan: Solusi Ingress Single-AZ yang Scalable
 22 Sep 2026
 16 mnt baca
Jika workload sengaja berada di satu Availability Zone, apakah ALB masih diperlukan? Pelajari alternatif ingress single-AZ dengan Route 53, Nginx, HAProxy, dan scaling.
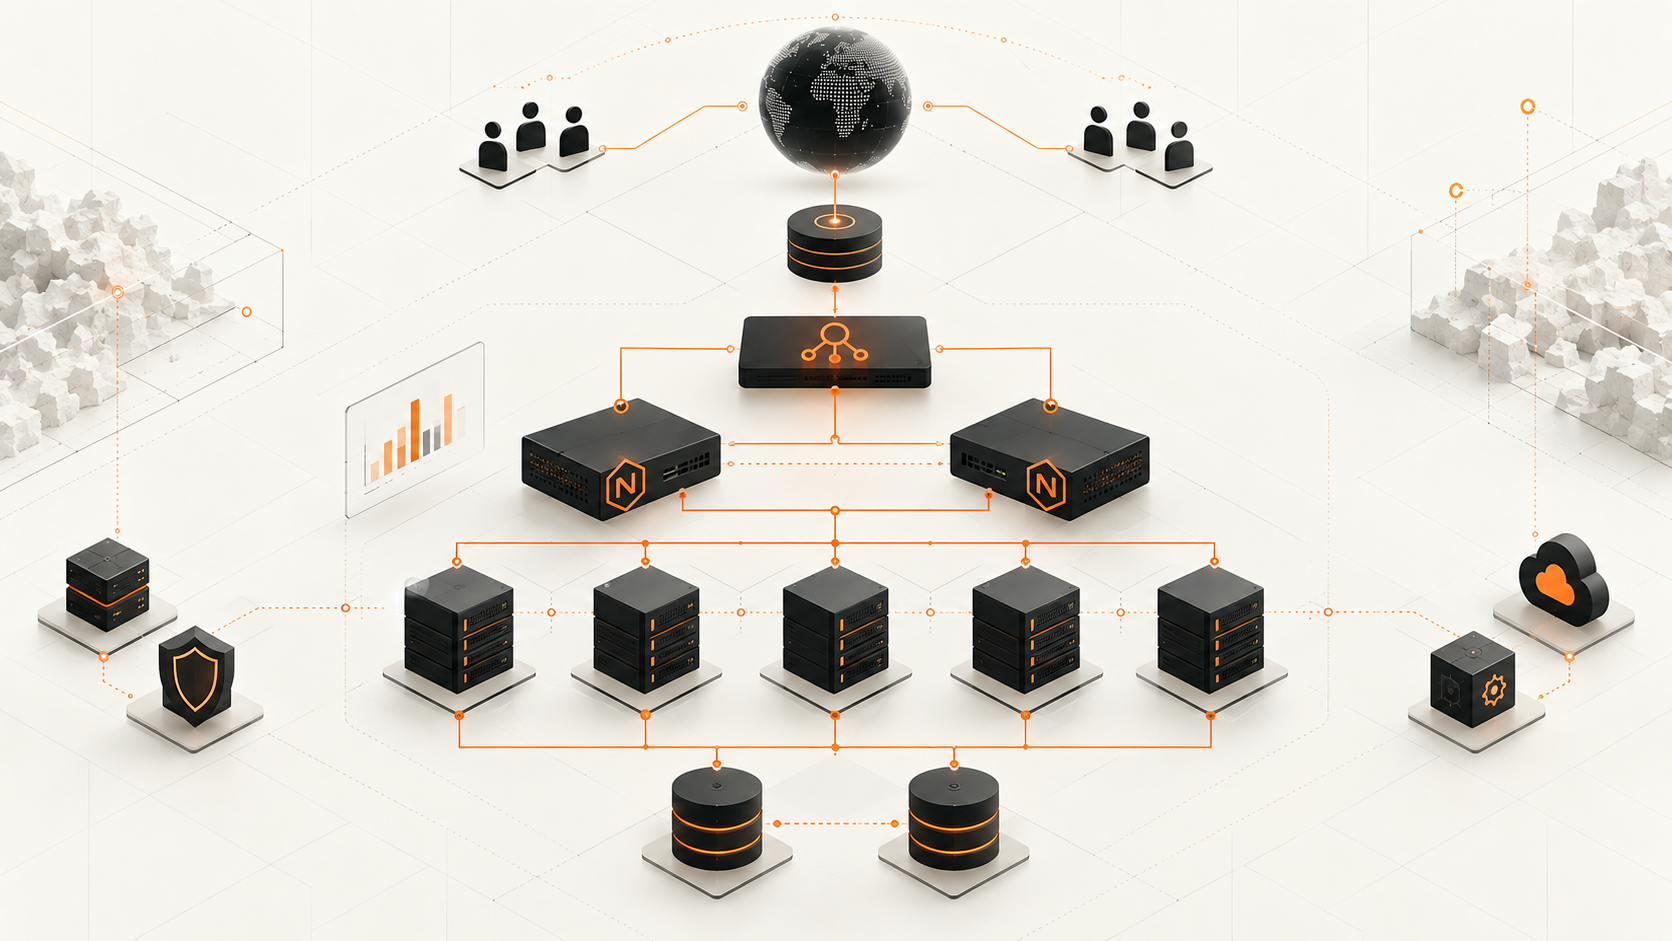
Pendahuluan: Mengapa ALB Tidak Selalu Menjadi Jawaban Otomatis?
Dalam desain AWS, ada satu kebiasaan yang sangat mudah terjadi: begitu sebuah aplikasi memiliki lebih dari satu EC2 instance, kita langsung menambahkan Application Load Balancer (ALB). Secara umum keputusan itu masuk akal. ALB adalah layanan managed, mendukung HTTP/HTTPS, health check, listener rules, target groups, TLS termination, dan integrasi erat dengan ekosistem AWS.
Namun ada pertanyaan yang lebih fundamental: apakah kita memang membutuhkan load balancer managed jika seluruh workload sengaja ditempatkan hanya di satu Availability Zone (AZ)?
Pertanyaan ini menjadi menarik ketika tujuan arsitektur bukan mengejar multi-AZ high availability, melainkan membangun single-AZ architecture yang sangat efisien biaya, memiliki throughput tinggi, dapat scale secara horizontal, dan tetap memiliki mekanisme failure handling yang masuk akal. Dalam konteks tersebut, ALB bisa saja tetap digunakan, tetapi bukan berarti ALB selalu menjadi komponen wajib.
AWS mendokumentasikan bahwa ALB dapat mengaktifkan beberapa Availability Zone dan secara default mendistribusikan request ke target yang terdaftar di seluruh AZ yang diaktifkan. AWS juga merekomendasikan agar setiap AZ yang diaktifkan memiliki setidaknya satu target. Artinya, ALB memang sangat cocok sebagai bagian dari desain yang menggunakan failure domain lebih dari satu AZ.
Jadi, persoalannya bukan “ALB jelek untuk single-AZ”. Persoalannya adalah apakah fungsi yang diberikan ALB sepadan dengan kebutuhan arsitektur yang memang sengaja dibatasi pada satu failure domain.
01. Bedakan Availability dengan Scalability
Kesalahan pertama dalam diskusi ini adalah menganggap high availability dan horizontal scalability sebagai hal yang sama.
Padahal keduanya berbeda.
Misalkan kita memiliki satu AZ dengan empat EC2:
                    Internet
                       |
                       v
                 Ingress Layer
                       |
          +------------+------------+
          |            |            |
          v            v            v
        EC2-1        EC2-2        EC2-3
                                     |
                                   EC2-4
Keempat instance tersebut bisa melakukan horizontal scaling. Ketika traffic meningkat, kita dapat menambah instance. Ketika traffic turun, kita dapat mengurangi instance.
Tetapi seluruh instance masih berada dalam failure domain yang sama.
Jika AZ tersebut mengalami gangguan besar, empat instance tersebut dapat terdampak secara bersamaan.
Sebaliknya, multi-AZ:
                         Internet
                            |
                         Ingress
                            |
             +--------------+--------------+
             |                             |
            AZ-A                          AZ-B
             |                             |
        +----+----+                   +----+----+
        |    |    |                   |    |    |
       EC2  EC2  EC2                 EC2  EC2  EC2
memberikan failure-domain separation.
Jadi apabila organisasi memang mengatakan, “Untuk workload ini kami menerima risiko single-AZ demi cost efficiency,” maka jangan secara otomatis memasukkan komponen yang tujuan utamanya sering diasosiasikan dengan multi-AZ availability.
Itu bukan berarti ALB tidak berguna. Itu berarti desain harus dimulai dari requirement, bukan dari daftar layanan AWS yang biasanya digunakan.
02. Apa Sebenarnya yang Kita Butuhkan dari ALB?
Sebelum mengganti ALB, kita harus memecah fungsi ALB.
ALB pada dasarnya memberikan beberapa kemampuan penting:
- menerima koneksi HTTP/HTTPS dari client;
- TLS termination;
- routing berdasarkan host dan path;
- health checking;
- distribusi request ke target;
- connection management;
- integrasi dengan target groups;
- integrasi dengan security model AWS;
- observability melalui metrik dan access log;
- integrasi dengan Auto Scaling dan service AWS lainnya.
Jadi jika kita berkata “hapus ALB”, pertanyaan berikutnya harus selalu:
Fungsi mana yang sebelumnya diberikan ALB dan sekarang akan diberikan oleh komponen apa?
Ini adalah cara berpikir yang jauh lebih sehat dibanding mengganti ALB dengan Nginx hanya karena Nginx lebih murah.
Kalau ALB dihapus lalu seluruh fungsi tersebut hilang, kita bukan sedang melakukan optimasi arsitektur. Kita hanya sedang memindahkan kompleksitas ke tempat lain.
03. Single-AZ Tidak Berarti Harus Single-Instance
Ini bagian yang sering disalahpahami.
Single-AZ bukan berarti:
Internet
   |
   v
EC2
Arsitektur seperti itu memang murah, tetapi scalability dan failure handling-nya sangat terbatas.
Single-AZ yang lebih serius justru dapat berbentuk:
                         Internet
                            |
                         Route 53
                            |
                     Ingress EC2
                    Nginx / HAProxy
                            |
             +--------------+--------------+
             |              |              |
             v              v              v
           App-1          App-2          App-3
             |              |              |
             +--------------+--------------+
                            |
                        Database
Ingress dan application tier dapat sama-sama menggunakan beberapa instance.
Masalah berikutnya menjadi sangat penting:
Bagaimana traffic masuk ke beberapa ingress instance tanpa ALB?
Di sinilah kita mulai membutuhkan desain yang berbeda.
04. Solusi Pertama: Route 53 + Multiple Ingress
Salah satu pola yang dapat digunakan adalah memanfaatkan Route 53 untuk mendistribusikan DNS resolution ke beberapa endpoint.
Contohnya:
                    api.example.com
                           |
                       Route 53
                    Weighted Records
                     /      |      \
                    /       |       \
                   v        v        v
               Ingress-1 Ingress-2 Ingress-3
                   |        |        |
                   +--------+--------+
                            |
                       Application
Route 53 mendukung routing policy seperti weighted routing dan health checking. AWS juga mendokumentasikan konfigurasi DNS failover untuk beberapa resource yang menjalankan fungsi yang sama, termasuk web server.
Dengan model seperti ini, ingress tidak harus berupa satu server.
Misalnya:
- Ingress-1 menerima sekitar 50% traffic.
- Ingress-2 menerima sekitar 30%.
- Ingress-3 menerima sekitar 20%.
Atau seluruh ingress dapat diberi bobot yang sama.
Jika salah satu endpoint dianggap unhealthy oleh health check, Route 53 dapat berhenti mengikutsertakan record tersebut dalam respons routing sesuai konfigurasi yang digunakan.
Namun ada satu catatan penting: DNS load balancing bukan request-level load balancing.
Route 53 tidak menerima setiap HTTP request lalu memilih backend seperti ALB. Route 53 memberikan jawaban DNS, dan client/resolver kemudian menggunakan alamat yang diperoleh.
Karena itu perilakunya berbeda dengan ALB.
05. DNS Load Balancing Memiliki Karakteristik Berbeda
Misalnya client mendapatkan:
api.example.com -> 10.0.1.10
Client kemudian melakukan banyak request ke endpoint tersebut.
Request-request berikutnya tidak otomatis kembali ke Route 53 untuk memilih instance lain. DNS caching, resolver behavior, connection reuse, dan TTL dapat menyebabkan traffic tetap berada pada endpoint yang sama untuk suatu periode.
Karena itu Route 53 bukan pengganti satu-banding-satu untuk ALB.
Tetapi untuk arsitektur tertentu, karakteristik tersebut justru dapat diterima.
Jika aplikasi menggunakan koneksi HTTP modern, keep-alive, dan backend yang stateless, desain DNS-based distribution dapat bekerja dengan baik pada workload tertentu.
Kuncinya adalah memahami bahwa kita sedang memilih model distribusi traffic yang berbeda, bukan mendapatkan ALB versi gratis.
06. Solusi Kedua: Nginx atau HAProxy sebagai Ingress
Alternatif yang lebih dekat dengan perilaku ALB adalah menggunakan software load balancer sendiri.
Misalnya:
Internet
   |
   v
Ingress-1
Nginx / HAProxy
   |
   +---- App-1
   +---- App-2
   +---- App-3
   +---- App-4
Nginx dan HAProxy dapat melakukan reverse proxy dan load balancing pada layer aplikasi.
Contoh sederhana Nginx:
upstream application {
    least_conn;

    server 10.0.10.11:8080;
    server 10.0.10.12:8080;
    server 10.0.10.13:8080;
}

server {
    listen 443 ssl http2;

    location / {
        proxy_pass http://application;
    }
}
Dengan model ini, application server tidak perlu terekspos langsung ke Internet.
Security group dapat dirancang sehingga:
Internet
   |
   v
Ingress SG
   |
   v
Application SG
Application security group hanya menerima traffic dari ingress layer.
Ini memberikan security boundary yang cukup jelas.
07. Tetapi Jangan Membuat Satu Nginx Menjadi Single Point of Failure
Inilah jebakannya.
Kita menghapus ALB karena ingin mengurangi biaya, kemudian membuat:
Internet
   |
   v
Nginx-1
   |
   +---- App-1
   +---- App-2
   +---- App-3
Sekarang Nginx-1 mati.
Aplikasi ikut mati.
Kita baru saja mengganti managed load balancer dengan satu server yang menjadi single point of failure.
Jika ingin ingress layer sendiri, sebaiknya kita juga mempertimbangkan redundancy:
                         Internet
                            |
                         Route 53
                        /         \
                       /           \
                      v             v
                  Nginx-1       Nginx-2
                      |             |
                      +------+------+
                             |
                  +----------+----------+
                  |          |          |
                 App-1      App-2      App-3
Tetapi sekarang muncul pertanyaan baru:
Bagaimana Route 53 mengetahui Nginx-1 mati?
Jawabannya adalah health check.
AWS Route 53 dapat melakukan health check terhadap endpoint dan menggunakan status kesehatan tersebut dalam konfigurasi routing atau failover.
08. Route 53 Health Check sebagai Failure Detector
Health check sebaiknya tidak hanya memeriksa apakah port 443 terbuka.
Lebih baik gunakan endpoint seperti:
GET /health
atau:
GET /ready
Health endpoint idealnya membedakan antara:
- process hidup;
- application siap menerima traffic;
- dependency penting tersedia;
- database dapat digunakan jika memang diperlukan untuk request tersebut.
Namun jangan membuat health check terlalu kompleks.
Jika endpoint health check membutuhkan database, Redis, third-party API, dan lima dependency lain, sebuah gangguan dependency kecil dapat membuat seluruh ingress dianggap unhealthy.
Akibatnya sistem DNS dapat melakukan failover padahal server sebenarnya masih mampu menangani sebagian besar traffic.
Health check harus merepresentasikan kondisi yang benar-benar menentukan apakah endpoint layak menerima traffic.
09. Single-AZ dengan Dua Ingress: Apakah Benar-Benar High Availability?
Tidak.
Dan ini harus dikatakan secara jujur.
Jika:
AZ-A
 |
 +-- Ingress-1
 +-- Ingress-2
 +-- App-1
 +-- App-2
 +-- App-3
maka kita memiliki redundancy di dalam AZ, tetapi belum memiliki AZ-level redundancy.
Jika Ingress-1 mati, Ingress-2 masih bisa melayani.
Jika App-1 mati, App-2 dan App-3 masih bisa melayani.
Tetapi jika AZ-A mengalami outage, seluruh stack tersebut dapat hilang sekaligus.
Jadi istilah yang lebih tepat adalah:
redundant single-AZ architecture
bukan multi-AZ high availability.
Terminologi ini penting karena arsitektur yang baik harus menyatakan risiko secara eksplisit, bukan menyembunyikannya di balik kata “HA”.
10. Bagaimana Jika Traffic Sangat Besar?
Di sinilah desain single-AZ menjadi lebih menarik.
Misalnya kita memiliki:
Ingress
   |
   +---- App-01
   +---- App-02
   +---- App-03
   +---- ...
   +---- App-50
Ingress menjadi bottleneck.
Kita kemudian dapat membuat ingress layer sendiri menjadi horizontally scalable:
                    Route 53
                 /      |      \
                v       v       v
          Ingress-1 Ingress-2 Ingress-3
              |        |        |
              +--------+--------+
                       |
        +--------------+--------------+
        |       |       |       |      |
       App1    App2    App3    App4   AppN
Sekarang DNS melakukan coarse-grained distribution ke ingress nodes.
Setiap ingress node melakukan fine-grained load balancing ke application nodes.
Ini adalah dua level load balancing:
DNS Distribution
       |
       v
Ingress Distribution
       |
       v
Application Distribution
Dengan desain seperti ini, kita dapat meningkatkan throughput dengan menambah ingress node dan application node.
Tetapi kompleksitas operasional juga meningkat.
11. Jangan Lupakan Connection dan TLS
ALB memberikan banyak pekerjaan operasional secara managed.
Ketika menggunakan Nginx atau HAProxy, kita harus memikirkan sendiri:
- TLS certificates;
- certificate renewal;
- TLS protocol;
- cipher configuration;
- HTTP/2;
- connection timeout;
- keep-alive;
- request timeout;
- upstream timeout;
- maximum connections;
- connection draining;
- retry behavior;
- client IP forwarding;
- logging;
- metrics;
- graceful reload.
Misalnya deployment application baru.
Jika App-2 akan dihentikan, ingress harus berhenti mengirim request baru ke App-2 sebelum process benar-benar dimatikan.
Kalau tidak, kita dapat mengalami:
Deploy
  |
  v
App restart
  |
  +--> existing request terminated
  |
  +--> 502 / 504
Dengan managed load balancer, sebagian mekanisme tersebut sudah menjadi bagian dari layanan. Dengan self-managed ingress, engineering team harus mendesainnya.
12. Security: Jangan Sampai Penghematan ALB Mengorbankan Security
Menghilangkan ALB tidak berarti security group harus dibuka ke dunia.
Pola yang lebih baik:
                 Internet
                    |
                    v
             Ingress Security Group
                    |
                    v
             Application Security
                    |
                    v
              Database Security
Misalnya:
Ingress SG
- TCP 443 dari Internet.
- TCP 80 hanya jika diperlukan untuk redirect HTTP → HTTPS.
Application SG
- menerima port aplikasi hanya dari Ingress SG.
Database SG
- menerima port database hanya dari Application SG.
Dengan demikian application instance tidak perlu memiliki inbound rule:
0.0.0.0/0 -> 8080
yang merupakan pola yang sebaiknya dihindari.
Security architecture tetap harus dipertahankan walaupun ALB dihapus.
13. Elastic IP atau DNS?
Pertanyaan berikutnya adalah bagaimana membuat endpoint ingress tetap stabil.
Ada beberapa pendekatan.
Pendekatan A — Public IP langsung
Instance ingress memiliki public IPv4.
Masalahnya adalah lifecycle instance dapat menyebabkan alamat berubah.
Pendekatan B — Elastic IP
Ingress menggunakan Elastic IP sehingga alamat publik tetap.
Ini cocok untuk desain tertentu yang membutuhkan IP statis.
Namun ketika memiliki beberapa ingress instance, kita memiliki beberapa IP:
Ingress-1 -> EIP-1
Ingress-2 -> EIP-2
Ingress-3 -> EIP-3
Route 53 kemudian dapat menjadi layer distribusi.
Pendekatan C — NLB
Jika kebutuhan sebenarnya adalah static IP, high throughput, dan load balancing pada network layer, Network Load Balancer dapat menjadi alternatif yang lebih sesuai dibanding ALB untuk kasus tertentu.
NLB dapat menggunakan Elastic IP per Availability Zone pada internet-facing configuration.
Tetapi jika tujuan utamanya benar-benar menghilangkan managed load balancer untuk mengurangi biaya dan kompleksitas, NLB tentu bukan solusi “tanpa load balancer”.
Ia adalah alternatif jenis load balancer.
14. CloudFront Juga Bukan Pengganti ALB Secara Langsung
Ada kecenderungan lain:
“Kalau ALB tidak digunakan, pakai CloudFront saja.”
Ini juga tidak selalu benar.
CloudFront adalah CDN dan edge delivery platform. Ia sangat berguna untuk caching, TLS termination di edge, distribusi global, dan mengurangi request tertentu yang harus sampai ke origin.
Tetapi CloudFront bukan pengganti langsung ALB untuk melakukan load balancing application server secara umum.
Arsitektur:
Client
  |
  v
CloudFront
  |
  v
Origin
  |
  v
Application
dapat sangat efektif jika workload cocok dengan caching dan origin architecture.
Tetapi untuk dynamic application dengan banyak request yang semuanya harus diproses origin, kita tetap perlu memikirkan bagaimana origin tersebut menerima dan mendistribusikan traffic.
15. Pola Arsitektur yang Menarik: CloudFront + Single-AZ Ingress
Untuk aplikasi tertentu, kombinasi ini dapat masuk akal:
                         Internet
                            |
                            v
                       CloudFront
                            |
                            v
                     Route 53 / DNS
                            |
                  +---------+---------+
                  |                   |
                  v                   v
              Ingress-1           Ingress-2
                  |                   |
                  +---------+---------+
                            |
                   Application Tier
                            |
              +-------------+-------------+
              |             |             |
             EC2           EC2           EC2
CloudFront menangani edge delivery dan caching yang memang cocok untuk CDN.
Ingress menangani routing application.
Application tier melakukan business logic.
Namun arsitektur ini tidak otomatis lebih murah. CloudFront, data transfer, origin requests, ingress instances, monitoring, dan operational overhead semuanya harus dihitung.
16. Auto Scaling Tanpa ALB Bisa?
Bisa, tetapi perlu desain yang lebih hati-hati.
Banyak orang menganggap:
Auto Scaling Group = harus menggunakan ALB.
Tidak selalu.
Auto Scaling dapat digunakan untuk menjaga jumlah instance berdasarkan CPU, memory metric melalui CloudWatch Agent, request-related metrics, queue depth, atau custom metric.
Yang harus dipikirkan adalah bagaimana instance baru ditemukan oleh ingress.
Jika menggunakan Nginx dengan static upstream:
server 10.0.1.10;
server 10.0.1.11;
server 10.0.1.12;
maka ketika ASG menambah instance baru:
10.0.1.13
Nginx tidak otomatis mengetahui instance tersebut.
Maka kita memerlukan service discovery atau mekanisme konfigurasi otomatis.
Misalnya:
- AWS Cloud Map;
- internal DNS;
- automation melalui AWS API;
- configuration management;
- service registry;
- dynamic upstream mechanism;
- custom controller.
Di sinilah kompleksitas self-managed architecture mulai terlihat.
17. Jadi Mengapa Tidak Selalu Menggunakan ALB Saja?
Karena ada workload di mana biaya dan kompleksitas tambahan memang perlu dipertimbangkan.
Misalnya sebuah internal SaaS kecil memiliki:
- 2–5 EC2;
- satu AZ;
- traffic relatif stabil;
- application stateless;
- tidak membutuhkan advanced ALB routing;
- tidak membutuhkan multi-AZ;
- engineering team nyaman mengoperasikan Nginx;
- requirement latency dan throughput dapat dipenuhi dengan satu atau dua ingress instance.
Dalam kondisi seperti ini, self-managed ingress dapat menjadi pilihan arsitektur yang valid.
Tetapi jika organisasi tidak memiliki operational maturity untuk mengelola ingress, biaya manusia dapat jauh lebih besar daripada biaya ALB.
Ini adalah bagian yang sering dilupakan ketika orang mengatakan:
“Nginx gratis, ALB bayar.”
Software gratis tidak berarti sistem gratis.
18. Model Cost yang Harus Dibandingkan
Perbandingan biaya sebaiknya tidak hanya:
ALB Cost
vs
EC2 Cost
Yang lebih tepat:
Total Cost =
Infrastructure
+ Data Transfer
+ Monitoring
+ Logging
+ Operations
+ Engineering Time
+ Incident Cost
Misalnya self-managed ingress membutuhkan dua EC2.
Secara nominal kita mungkin menghemat biaya ALB, tetapi kemudian membutuhkan:
- dua EC2;
- EBS;
- patching;
- monitoring;
- log management;
- certificate automation;
- failover logic;
- deployment automation.
Pada workload kecil, ALB bisa jadi lebih sederhana.
Pada workload tertentu dengan traffic tinggi dan architecture yang sudah matang, self-managed ingress bisa memberikan cost/performance profile yang berbeda.
Karena itu keputusan seharusnya berdasarkan total cost of ownership, bukan harga satu service.
19. Single-AZ Architecture yang Dapat Dipertimbangkan untuk Workload Tertentu
Jika requirement-nya adalah:
- satu AZ;
- high throughput;
- horizontal scaling;
- application stateless;
- biaya efisien;
- tidak membutuhkan ALB-specific features;
- engineering team mampu mengelola Linux dan reverse proxy;
salah satu pola yang dapat dipertimbangkan adalah:
                         Internet
                            |
                            v
                     Route 53 DNS
                  Weighted + Health Check
                       /          \
                      /            \
                     v              v
                Ingress-1       Ingress-2
                Nginx/HAProxy   Nginx/HAProxy
                     |              |
                     +------+-------+
                            |
                     Application Tier
                            |
            +---------------+---------------+
            |               |               |
           EC2             EC2             EC2
            |               |               |
            +---------------+---------------+
                            |
                     Database / Cache
Ingress dibuat redundant.
Application dibuat horizontally scalable.
Route 53 menjadi coarse-grained traffic distribution dan health-based failover.
Nginx atau HAProxy menjadi request-level load balancer.
Auto Scaling mengelola application capacity.
CloudWatch mengelola observability.
Security group memisahkan Internet, ingress, application, dan database.
Tetapi seluruh sistem tetap berada dalam satu AZ.
Jadi kita mendapatkan:
horizontal scalability tanpa otomatis mendapatkan multi-AZ availability.
Itulah trade-off yang harus ditulis secara eksplisit dalam architecture document.
20. Kapan ALB Tetap Lebih Masuk Akal?
Ada banyak kondisi ketika ALB tetap merupakan pilihan yang rasional.
Misalnya aplikasi membutuhkan:
- host-based routing;
- path-based routing;
- banyak target groups;
- managed health checking;
- integrasi ECS;
- integrasi EKS;
- TLS termination managed;
- deployment yang sangat dinamis;
- operational simplicity;
- pengurangan beban pengelolaan reverse proxy;
- multi-AZ architecture.
Dalam kondisi tersebut, membangun Nginx sendiri hanya untuk menghindari biaya ALB dapat menjadi false economy.
Kita menghemat biaya AWS tetapi membeli kompleksitas operasional.
Dan kompleksitas itu pada akhirnya juga memiliki harga.
21. Kapan Single-AZ Tanpa ALB Mulai Menarik?
Pola ini mulai menarik ketika requirement memang sangat spesifik:
“Kami tidak membutuhkan multi-AZ. Kami membutuhkan throughput tinggi dengan cost yang dapat diprediksi, application tier horizontally scalable, dan kami memiliki kemampuan mengelola ingress sendiri.”
Dalam kasus tersebut, desain dapat menggunakan:
Route 53
    |
    +---- Ingress-1
    |
    +---- Ingress-2
    |
    +---- Ingress-N
              |
              v
       Application Fleet
Route 53 tidak menggantikan ALB.
Nginx tidak menggantikan semua fitur ALB.
Keduanya membentuk arsitektur berbeda dengan failure model berbeda.
Itulah poin yang paling penting.
22. Bagaimana dengan Database?
Menghilangkan ALB tidak otomatis berarti database juga harus single-AZ.
Layer dapat memiliki failure requirement yang berbeda.
Contohnya:
                Single-AZ Compute
                       |
              +--------+--------+
              |                 |
          Ingress           Application
              |                 |
              +--------+--------+
                       |
                       v
                  RDS / DB
Bisa saja compute tier sengaja single-AZ karena pertimbangan cost dan latency, sementara database menggunakan konfigurasi yang memberikan redundancy berbeda.
Sebaliknya, jika database juga single-AZ, maka risk profile harus dinyatakan secara eksplisit.
Arsitektur tidak harus memiliki satu aturan availability untuk semua komponen.
Yang penting adalah setiap layer memiliki availability requirement yang sesuai dengan business requirement.
23. Jangan Menganggap Single-AZ Sebagai Kesalahan
Dalam diskusi cloud architecture, multi-AZ sering dianggap sebagai default.
Padahal tidak semua workload memiliki requirement yang sama.
Ada aplikasi:
- internal;
- development;
- staging;
- batch;
- low criticality;
- cost-sensitive;
- workload dengan recovery strategy yang kuat;
- workload yang memang menerima outage AZ.
Untuk workload seperti itu, single-AZ dapat menjadi keputusan engineering yang rasional.
Yang tidak rasional adalah memilih single-AZ tetapi kemudian mengklaim bahwa sistem tersebut memiliki karakteristik availability yang sama dengan multi-AZ.
Single-AZ bukan salah. Yang salah adalah tidak memahami konsekuensinya.
24. Decision Matrix
| Requirement | ALB | Nginx/HAProxy | Route 53 DNS |
|---|---|---|---|
| HTTP/HTTPS load balancing | Sangat sesuai | Sangat sesuai | Tidak secara langsung |
| Host/path routing | Sangat sesuai | Sangat sesuai | Tidak |
| Health check | Managed | Harus dikelola | Managed DNS health check |
| Request-level distribution | Ya | Ya | Tidak |
| DNS-level distribution | Tidak | Tidak | Ya |
| Multi-AZ architecture | Sangat sesuai | Bisa | Bisa |
| Single-AZ architecture | Bisa | Bisa | Bisa |
| Operational overhead | Rendah | Lebih tinggi | Rendah |
| Fine-grained proxy control | Terbatas | Sangat tinggi | Tidak |
| Static public IP | Bukan fokus utama | Bisa dengan EIP | DNS layer |
| Cost optimization | Tergantung workload | Bisa menarik | Sangat rendah sebagai DNS layer |
| Self-managed | Tidak | Ya | Tidak |
| Kubernetes/ECS integration | Sangat baik | Tergantung implementasi | Terbatas |
Tidak ada satu baris yang mengatakan satu teknologi selalu menang.
Karena masing-masing menyelesaikan masalah yang berbeda.
25. Arsitektur Bukan Tentang Menghapus Service, Tetapi Memindahkan Responsibility
Ini mungkin bagian paling penting dari seluruh pembahasan.
Ketika kita menggunakan ALB:
AWS
 |
 +-- Load balancing
 +-- Health checking
 +-- TLS integration
 +-- Target management
 +-- Scaling infrastructure
Ketika kita menggunakan Nginx:
Engineering Team
 |
 +-- Load balancing
 +-- Health checking
 +-- TLS
 +-- Configuration
 +-- Scaling
 +-- Deployment
 +-- Monitoring
 +-- Failure handling
Jadi sebenarnya kita tidak menghilangkan pekerjaan.
Kita memindahkan pekerjaan.
ALB berarti membayar AWS untuk mengelola bagian tertentu dari infrastructure.
Nginx berarti membayar infrastructure yang lebih sederhana tetapi menerima lebih banyak operational responsibility.
Keputusan yang baik adalah mengetahui siapa yang ingin kita bayar: AWS atau engineering team.
26. Kesimpulan
Jika seluruh workload memang sengaja berada di satu Availability Zone, ALB tidak otomatis menjadi komponen wajib.
Kita dapat membangun arsitektur single-AZ dengan Route 53, Nginx atau HAProxy, beberapa ingress instance, application fleet yang horizontally scalable, health checking, Auto Scaling, dan security group berlapis.
Namun desain tersebut bukan “ALB gratis”.
Ia adalah arsitektur yang berbeda.
Route 53 melakukan DNS-level traffic distribution dan health-based routing. Nginx atau HAProxy melakukan request-level load balancing. Application instances melakukan horizontal scaling. Engineering team mengambil tanggung jawab yang sebelumnya diberikan oleh managed load balancer.
Dan yang paling penting: redundancy di satu AZ bukanlah multi-AZ high availability.
Jika requirement bisnis memang menerima risiko outage satu AZ, arsitektur single-AZ dapat menjadi pilihan yang masuk akal. Tetapi jika requirement sebenarnya adalah availability tinggi terhadap kegagalan AZ, maka menghapus ALB dan mempertahankan seluruh workload di satu AZ tidak menyelesaikan masalah fundamental tersebut.
Karena itu pertanyaan yang lebih tepat bukan:
“Apakah ALB diperlukan?”
Melainkan:
“Failure domain apa yang kita terima, throughput berapa yang kita butuhkan, responsibility operasional mana yang ingin kita kelola sendiri, dan berapa total biaya yang bersedia kita bayar?”
Dari sana barulah keputusan tentang ALB, Nginx, HAProxy, NLB, Route 53, atau kombinasi semuanya menjadi keputusan arsitektur—bukan sekadar keputusan memilih service AWS.
Referensi Resmi AWS
Post Terbaru
 22 Sep 2026
Podman vs Docker: Development dan Production
 22 Sep 2026
Apakah Mayoritas Menentukan Kebenaran?
 75x dibaca
57x dibaca
Post Terkait
 8 mnt baca
Cara Setup AWS Systems Manager (SSM) untuk Akses EC2 dari Personal PC Tanpa SSH
Strategi praktis untuk mengakses dan mengelola instance EC2 dari laptop/PC pribadi menggunakan AWS Systems Manager Sessi...
14 Jan 2026
 12 mnt baca
Cloudflare R2 vs AWS S3 vs Google Cloud Storage: Panduan Memilih Object Storage untuk Aplikasi Modern
Artikel ini membahas perbandingan mendalam antara Cloudflare R2, AWS S3, dan Google Cloud Storage sebagai solusi object...
14 Jan 2026
 27 mnt baca
Transformasi Manajemen Kredensial IT: Dari Bottleneck Manager ke Sistem Password Vault Terpusat
Artikel ini membahas strategi transformasi manajemen kredensial IT dari model manual yang bergantung pada Manager menjad...
14 Jan 2026